DeepSeek Technical Reports
Published Updated
DeepSeek-R1
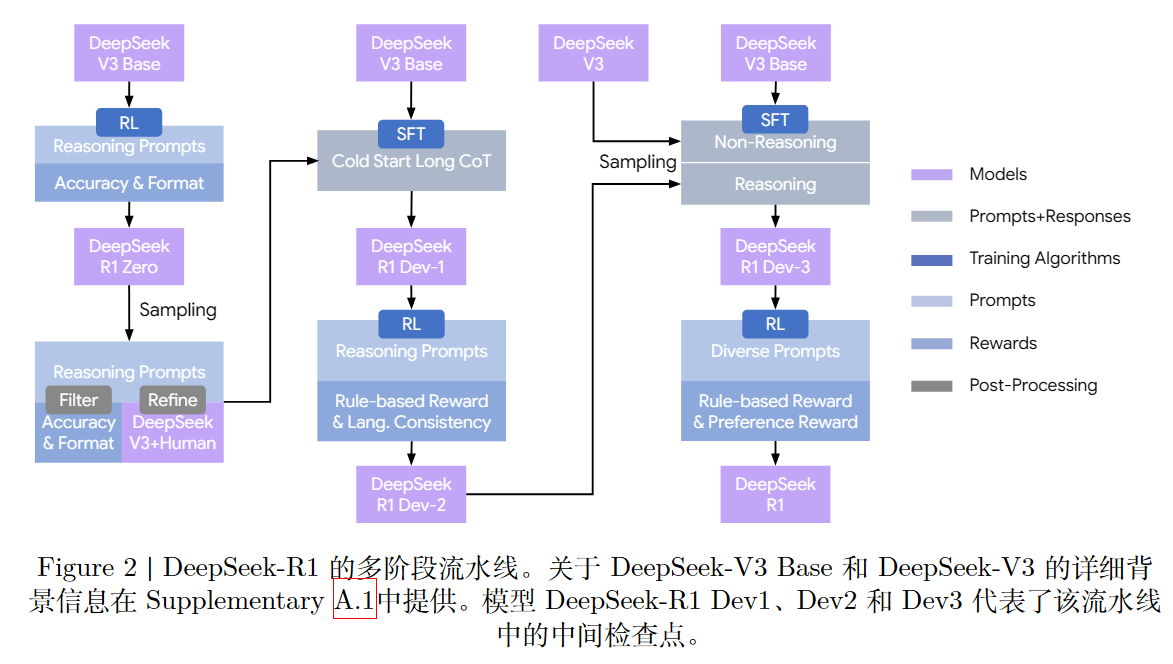
DeepSeek-V3.2
DSA
DSA (DeepSeek Sparse Attention) 在标准 Attention 前添加了一个 lightning indexer,用于检索出值得进行 Attention 的 token,只让这部分 token 与 query 做 Attention,这就是稀疏注意力,相当于 DSA 先做了一轮粗筛。
Lightning Indexer 的公式如下:
接下来逐个拆解各个部分: lightning indexer 计算 query token 和一个先前的 token 之间的检索分数,, 表示 token t 与 token s 之间的检索分数。 lightning indexer 由多个 head 组成, 表示 indexer heads 的数量, 是各个 head 的权重。设计的初衷是期望每个 head 能用于评估 token 的不同层面的价值,比如检查词义相关性、实体相关性、局部依赖、长距离依赖……当然实际训练出来的 head 不会有如此理想的人类语义,这种分 head 的思路其实和 MHA 以及 MoE 这些方法的思想是同构的。 使用 作为激活函数主要是考虑到效率。 indexer 有类似于 Attention 机制的 key/value,注意到公式中的 和 右上角都用 标识它是 indexer 的参数,防止与 Attention 混淆。 ,每个 query token 生成 个 参数,每个先前的 token 对应一个 。
得到当前 query token 与先前所有 token 之间的 index score 后,从中选出 TopK 的 token 进入 Attention 的计算,这就是 DSA。
是检索出的 TopK token 对应的 KV pairs。
DeepSeek-V4
huggingface 上有相对清晰简易的推理实现。
Architecture
mHC
mHC(Manifold-Constrained Hyper-Connections)是在 Hyper-Connections 的多残差流机制上增加几何约束:它让多条 residual streams 之间可以通过可学习矩阵动态混合,从而获得比普通残差连接更灵活的信息路由能力;但同时把负责 residual mixing 的矩阵限制在 doubly stochastic matrix 构成的 Birkhoff polytope 上,使每行、每列元素和都为 1,从而避免深层堆叠时信号被持续放大或衰减。简言之,mHC 的目标是在保留 HC 多路径表达能力的同时,恢复普通 residual connection 那种稳定的信息与梯度传播特性。
Hybrid Attention
CSA
Compressed Sparse Attention
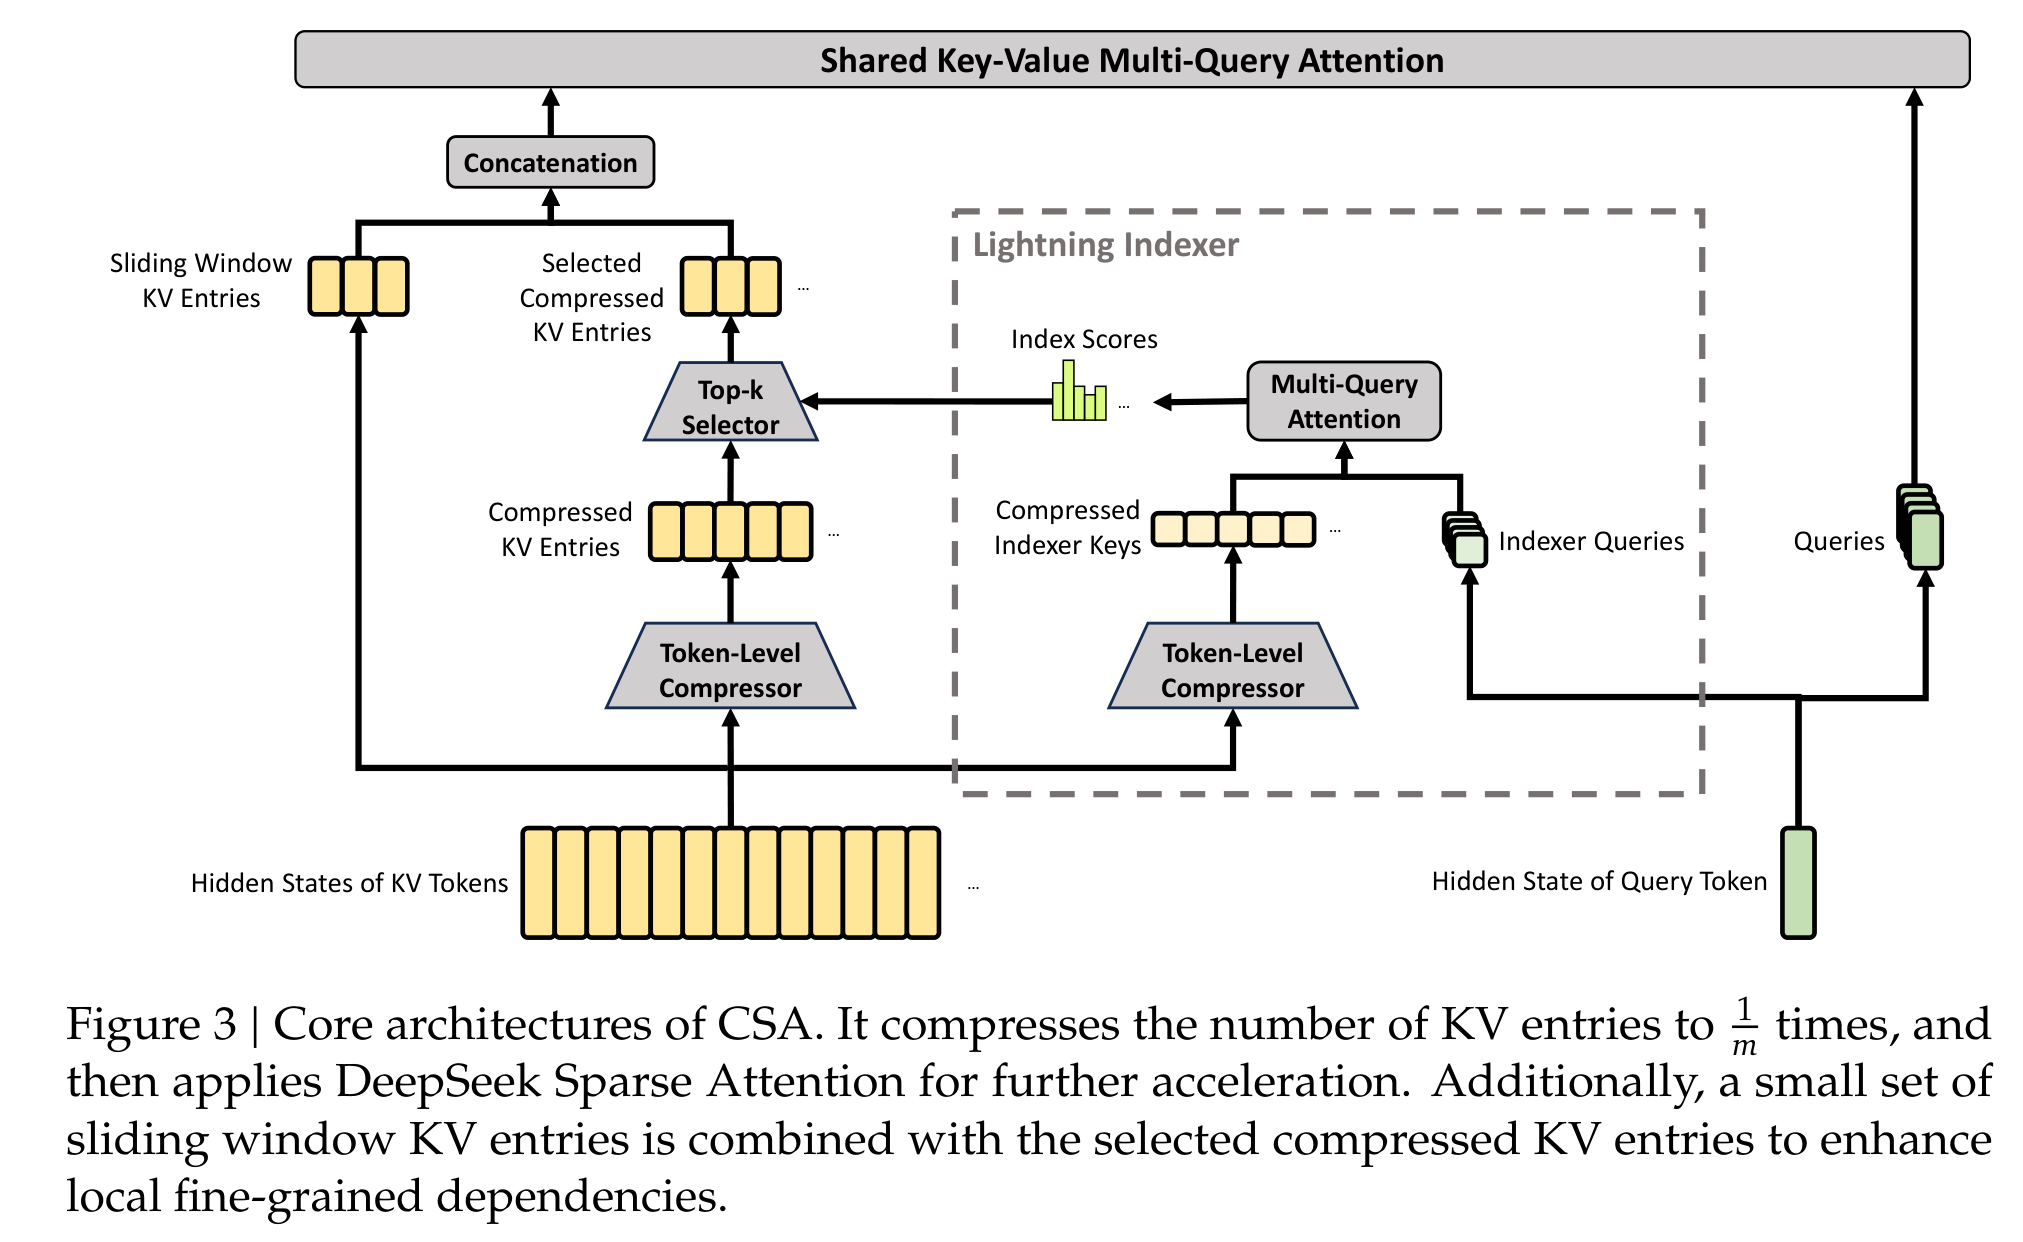
图中 Lightning Indexer 和 Top-k Selector 的部分就是 DSA。稀疏化本质上要求训推一体,期望在 train-free 的前提下引入 sparse 并不现实,需要让模型在训练中习惯稀疏化。 CSA 中 Sliding Window KV Entries 就是未压缩的 recent tokens,DeepSeek-V4 里取 ;indexer 使用的 KV 同样经过压缩,与 Attention KV 采用相同的压缩方式,二者在序列数量上一一对应,因此可以直接用它做 Top-K 检索;Compressed KV Entries 则是压缩后的 hidden states,属于类似卷积的有损压缩,无法逆向对应回某个特定 token,但可以专门训练一个 probe 在一定程度上还原语义。另外,由于 CSA 对 token 做了压缩,位置编码也需要相应的新处理方式,论文在 Partial Rotary Positional Embedding 一节中处理这一点。
HCA
Heavily Compressed Attention
HCA 相比 CSA 删去了 Sparse 部分,但提高了压缩率,即高压缩+全量注意力。HCA 的核心目标是建立低分辨率的全局视野。对于所有历史区域,都至少存在某个 compressed entry,而 query 对所有这些 entry 都做 attention。二者不在运行时动态权衡,而是预先定义在模型架构上,在 Transformer Layers 中交错使用。 HCA 用极强的信息压缩消灭 Top-k routing 的 coverage blind spot,让每隔若干层,所有历史区域都重新拥有一条通向当前 token 的 attention 路径。
总的来说,DSV4 的 Attention 机制用 Sliding Window 保留了局部细节,CSA 保证了远程检索精确度,HCA 保证了全局覆盖率/召回率。
Muon Optimizer
Muon: An optimizer for hidden layers in neural networks Muon is Scalable for LLM Training
Muon (MomentUm Orthogonalized by Newton-Schulz) 主要用于神经网络中的二维权重矩阵,例如 Transformer 的线性层,而 embedding、bias、norm 参数以及通常的输出 head 往往仍然交给 AdamW。
DeepSeek-V4.1
Architecture
CED
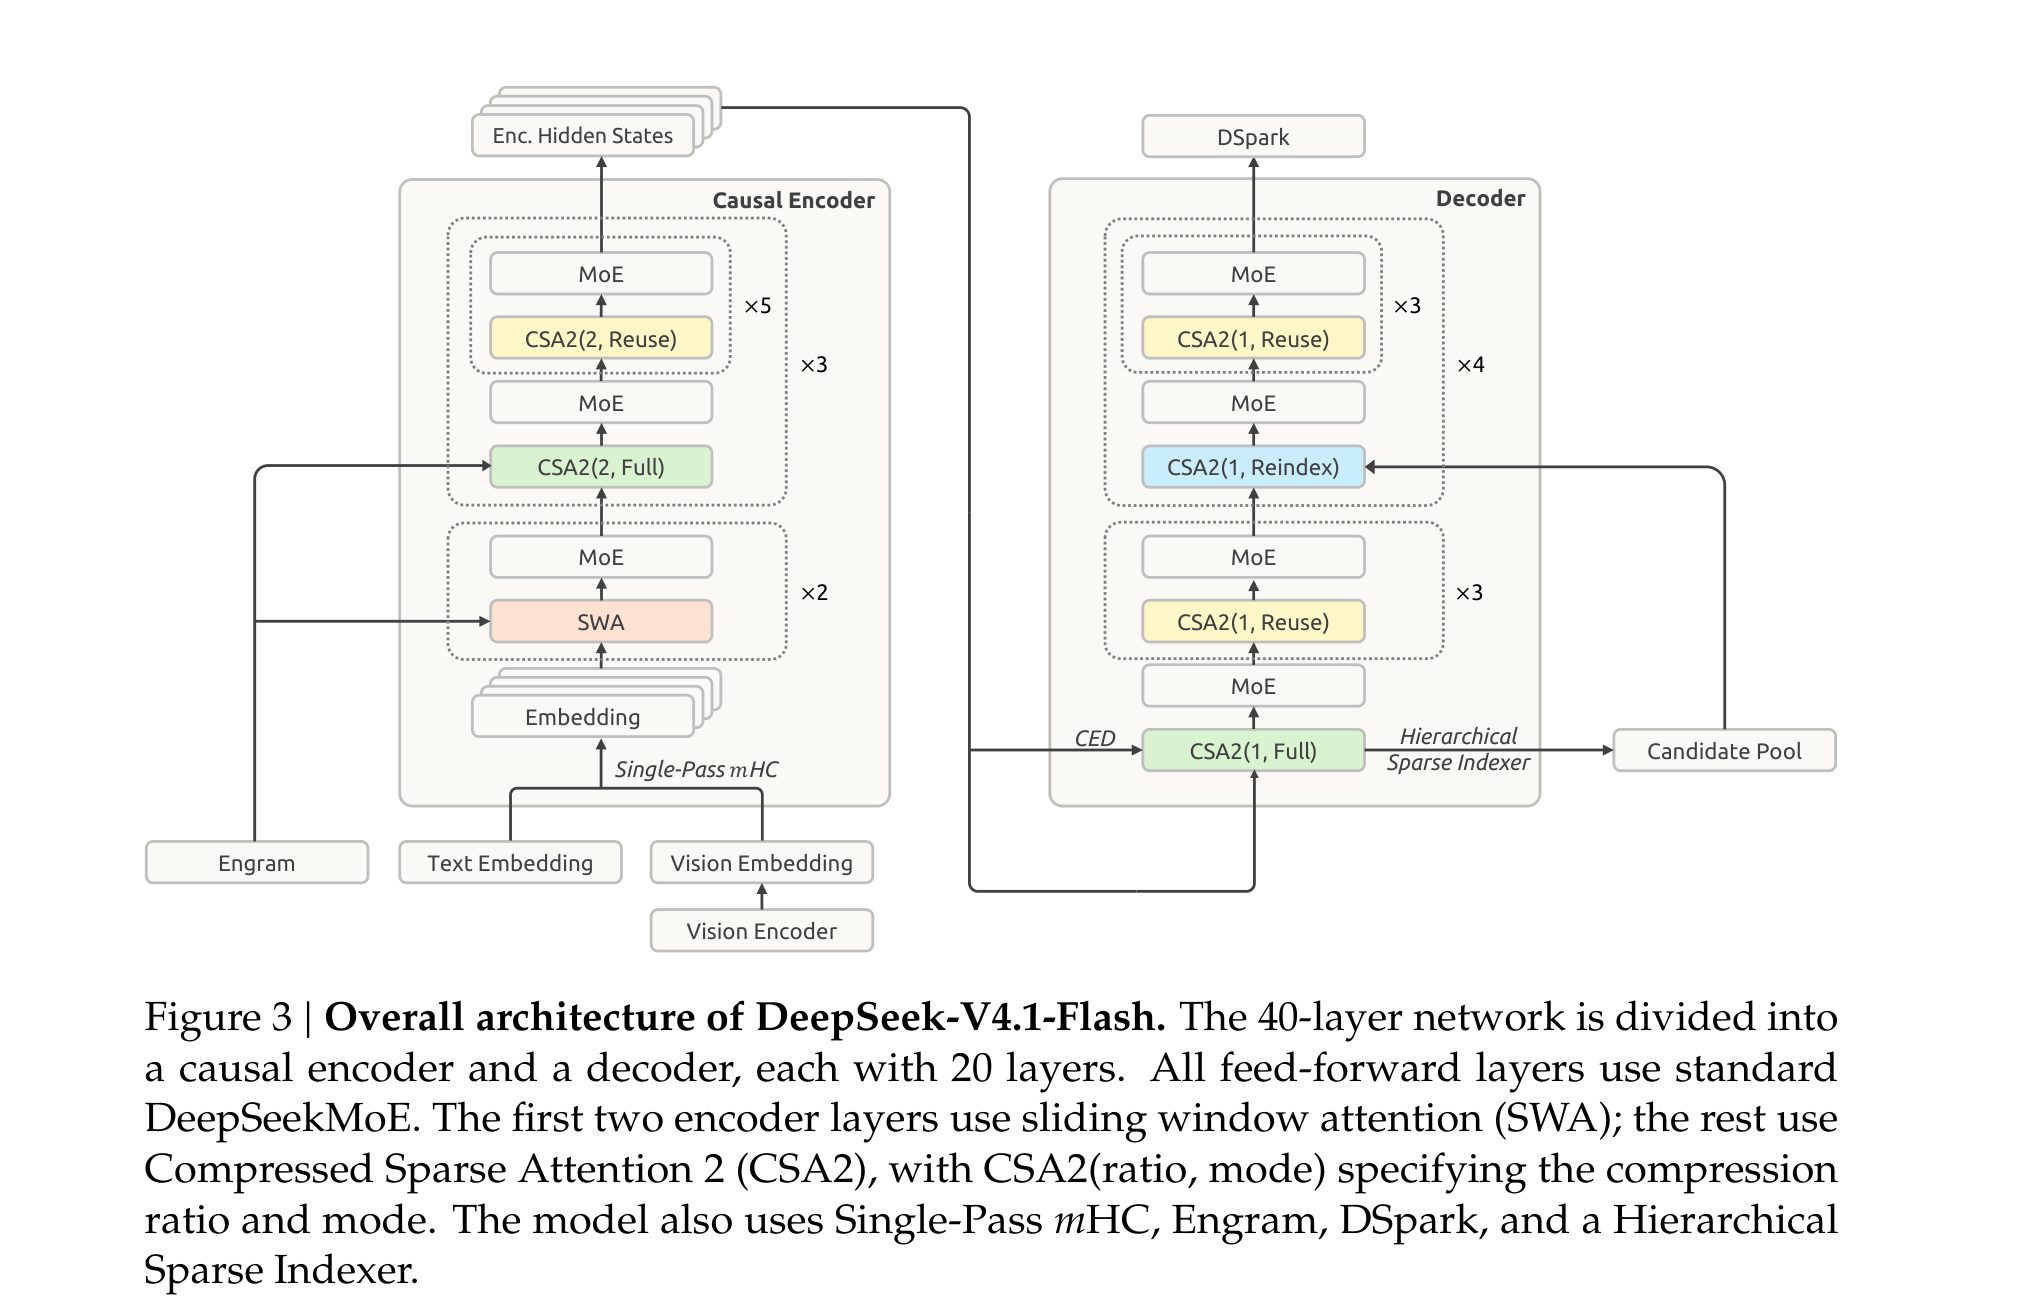
长 prompt 的历史信息只需要通过前半网络被充分编码一次,decoder 各层可以直接从这份 encoder representation 投影自己的 global KV,而无需让全部历史 token 再经过整个 decoder;同时用 layer-local SWA 保留 decoder 的局部深层计算能力,因此能在基本保留模型能力的同时,把长序列 prefill 的主计算量从 降到约 。
Causal Encoder 是 causal 的,注意不要和 Transformer 中做 bidirectional attention 的 encoder 搞混了。 Decoder 每一层的 KV 都通过 Causal Encoder 最后一层的 hidden states 投影计算得到:
是 KV Entries, 是 compression weights。 prefill 没有经过完整 的全层计算,只有 causal encoder 部分做完整的按层传递计算,并使用 SWA 维系 layer-wise 的信息传递,整体计算量接近减半。
数据流如下:
CSA2
CSA2 的稀疏化方向和 CED 是一致的,都尝试减少 layer dimension 的计算,做 cross-layer 的 KV 复用。
CSA2 原文开篇就表出背后的核心洞察,同时从 entry size / sequence dimension / layer dimension 三个维度减少开销。
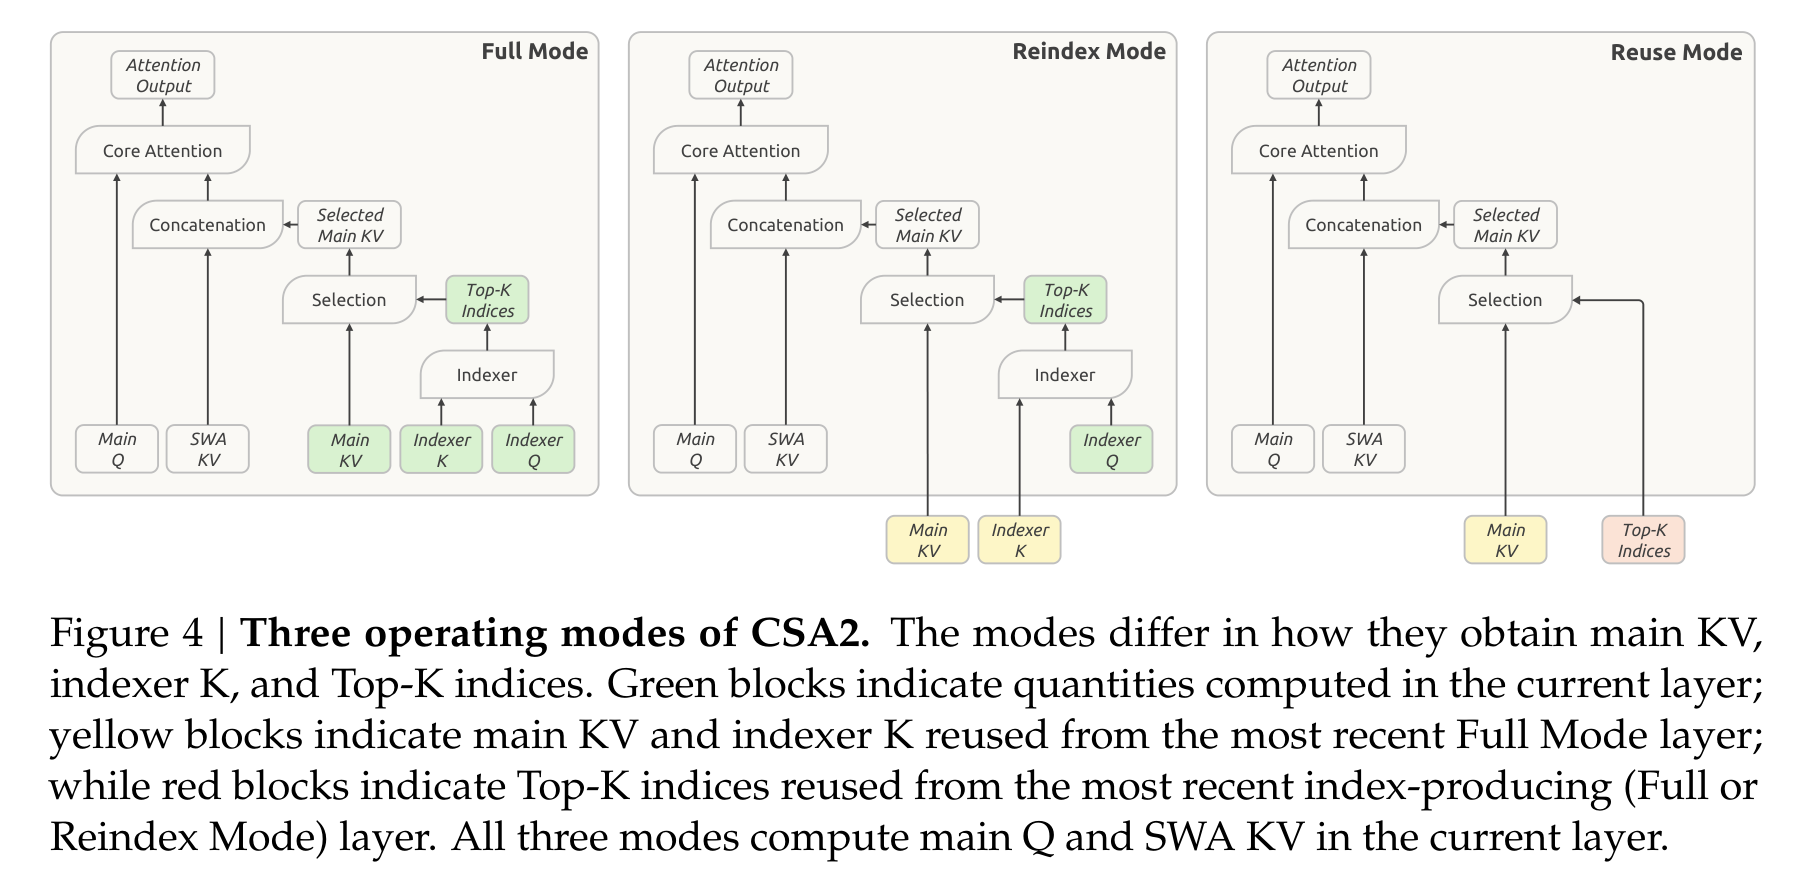 CSA2 的三种操作模式对应不同程度的复用,具体的复用规则参照原文。
CSA 中,各层需要独立运行 indexer 来决定当前 query 应关注哪些历史 KV。Cross-Layer KV and Index Reuse 的观察是,相邻层之间的历史表示以及 sparse retrieval 结果具有较强冗余,因此没有必要每层都重新生成 global KV、也没有必要每层都重新做 Top-K 检索。于是 CSA2 让多个层共享 main KV 和 indexer K,并在部分层用 Reindex Mode 根据当前层的 query 重新计算 Top-K,随后若干 Reuse Mode 层直接复用这一检索结果。
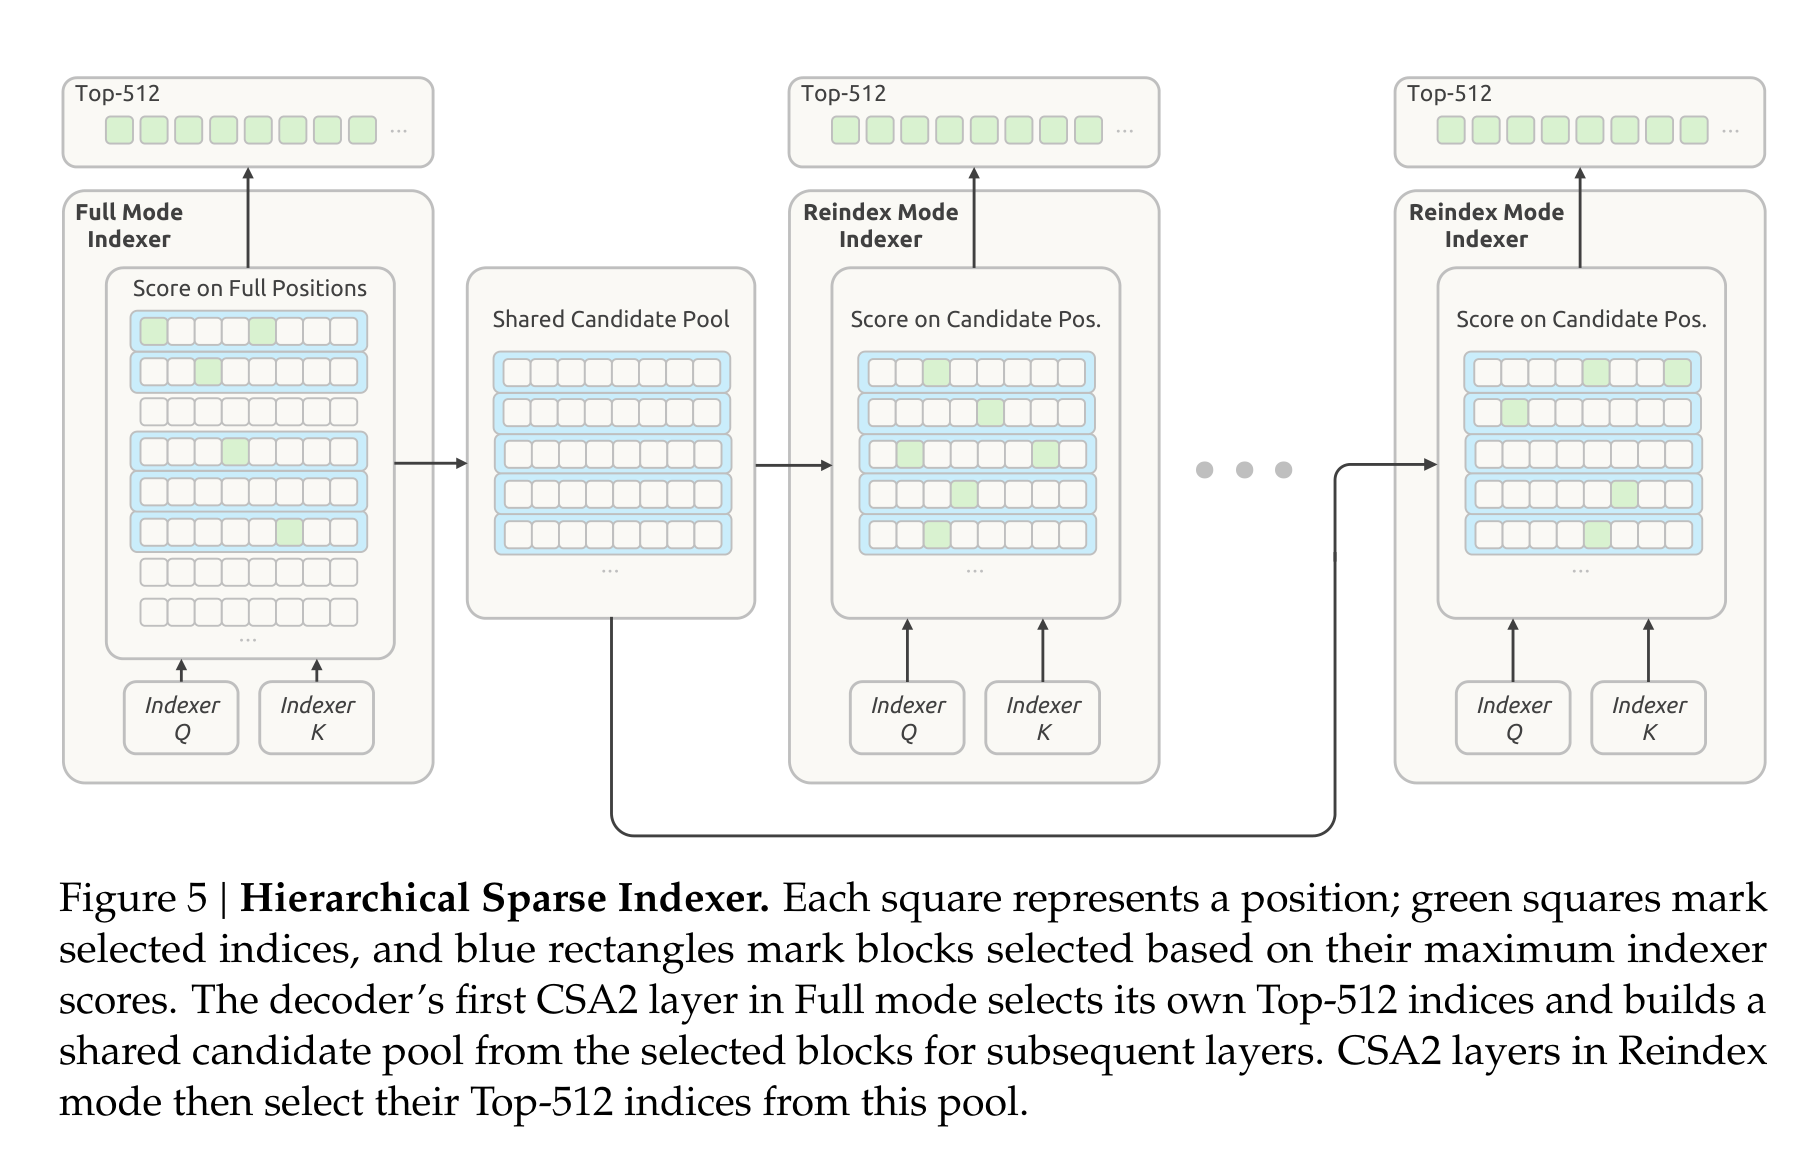
Hierarchical Sparse Indexer 假设不同深度的 indexer 虽然最终 Top-K 可以不同,但它们感兴趣的大致区域往往重叠。 因此第一层 Full indexer 扫完整 context 得到一个较大的 candidate pool,后续 Reindex layer 仍然重新打分,只不过只在这个候选池里搜,而不是扫描全部上下文。
Engram
Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models
DSpark
DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation
ParallelSpec: Parallel Drafter for Efficient Speculative Decoding 是最早提出 parallel drafter 的工作。DFlash 把 block diffusion 引入 speculative decoding,用 diffusion-style drafter 做 single-pass parallel drafting。
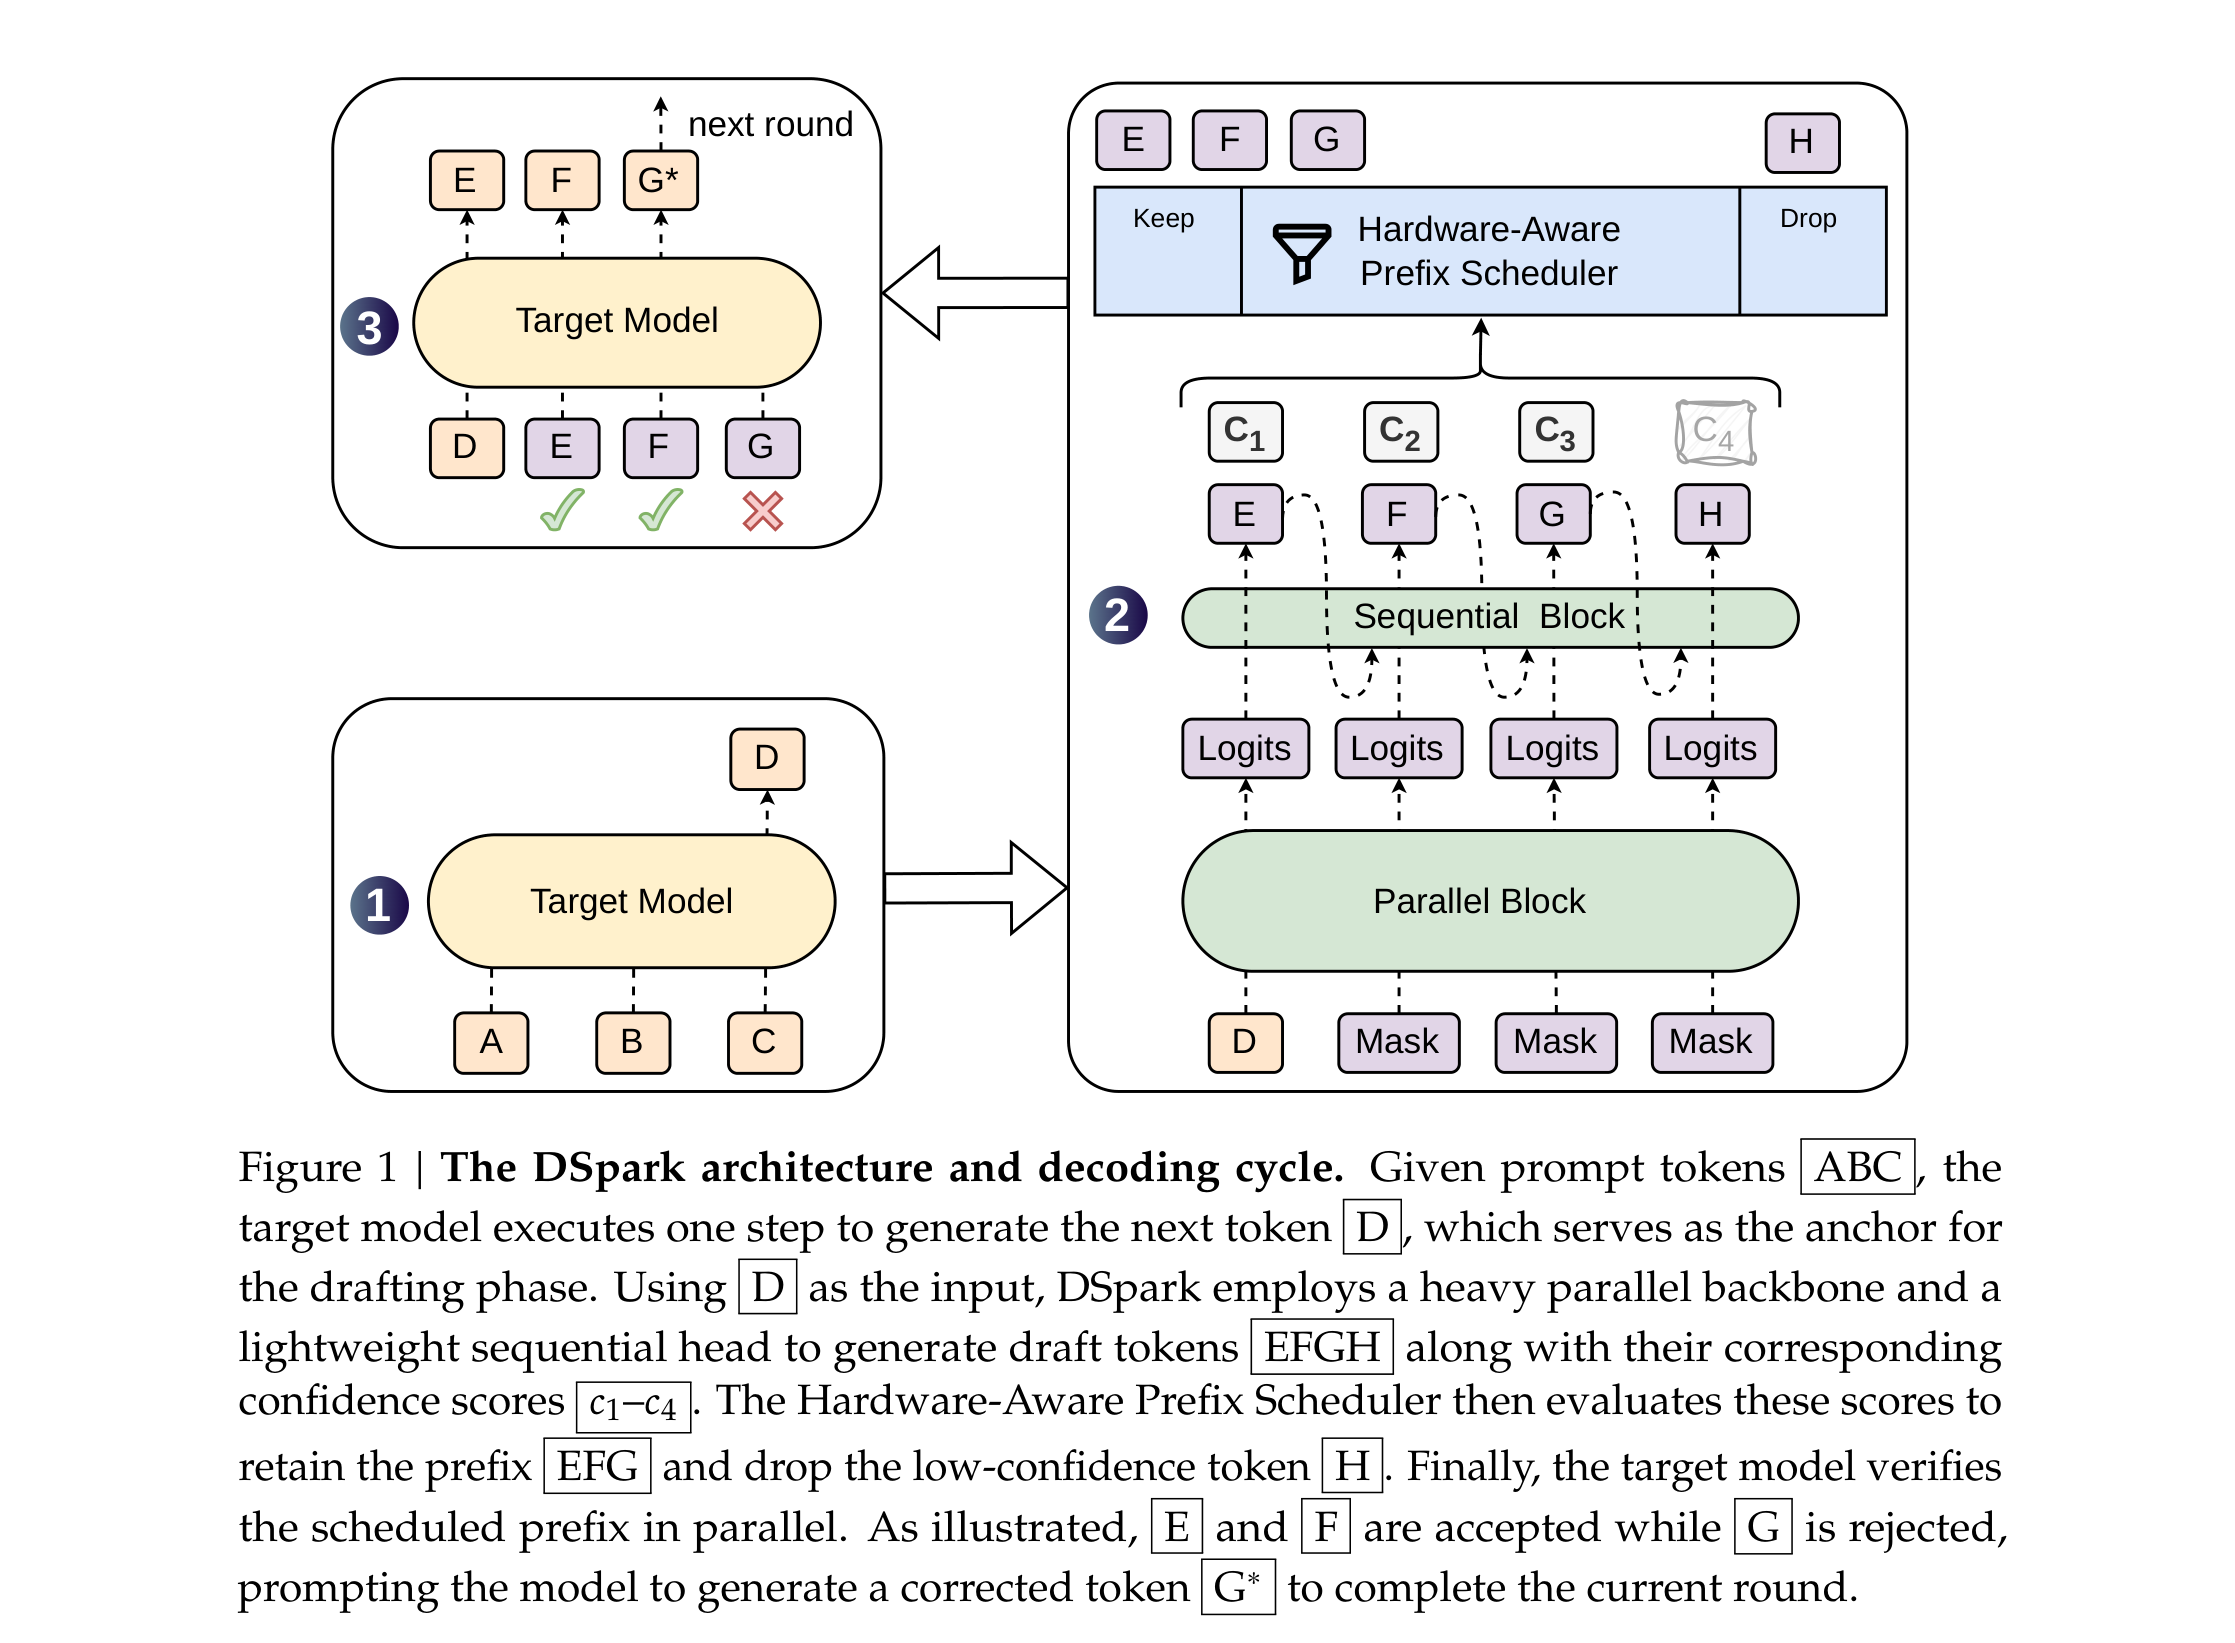
Semi-autoregressive generation
The average latency per generated token is:
是 draft model generation 的时间 是 target model verification 的时间 是被接受的 token 数 是 draft model 生成的 token 数
为了降低延时,有三种方法,降低 ,降低 ,增大 。面对这个优化目标,触及了 Pareto Frontier,也可以看作是一种不可能三角。
现在 parallel 的方法能在不增加 的前提下增大 ,但由于是 non-autoregressive model,它对上下文间的建模能力不够强,导致 的劣化。为了提高 draft 被 target model 接受的概率,又引入一个 sequence block 用于建模 token-wise 的联系,从而在 和 之间取得一个良好的 tradeoff,最终降低整体延时,拓展 Pareto frontier。本文称其为 semi-autoregressive generation。
Parallel stage 输出 anchor+𝛾−1 tokens 的 draft logits,Sequential stage 在 base logit vector 上加偏移量,这个 bias 是蕴含上下文信息的,就是下面公式里的 。 为了保证 draft 的效率,整体的计算应当是 parallel stage bounded 的,因此 Dspark 选择使用 Markov head 或 RNN head 来计算 bias。
DSpark 的 Parallel Backbone 只在 DFlash 的基础上对 anchor 的处理做了小的改动。
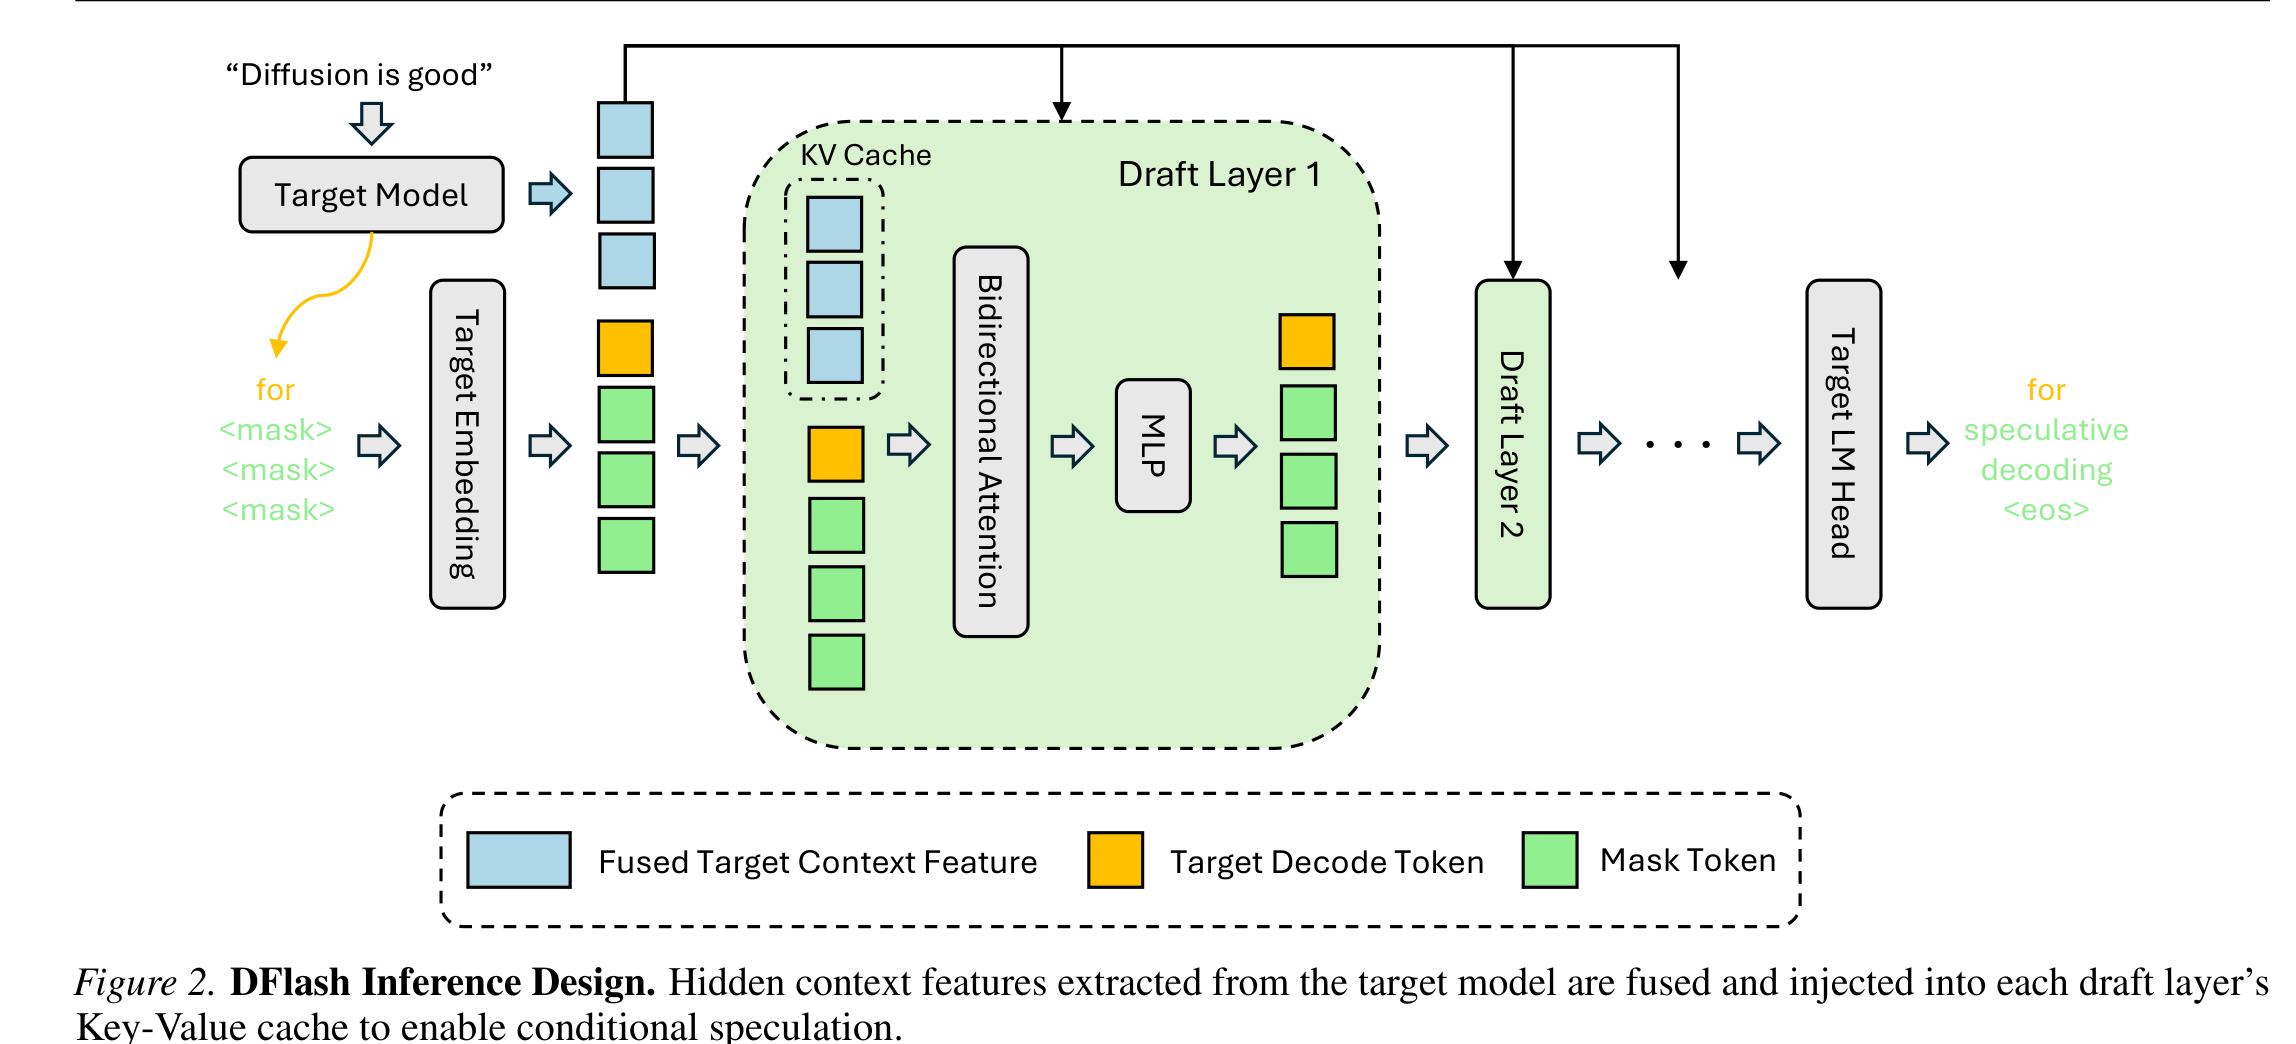
LLDM (Large Language Diffusion Model) 的任务是生成完整序列。它需要将如下 mask 序列通过多步 denoising 逐渐恢复整个 response。
DFlash 的目标是预测 ,输入:
其中 是已经验证过的 anchor token。
DFlash 相比先前的 Diffusion & Spec. 工作新设计是 Persistent KV Injection:diffusion draft model 每一层都直接接触 target feature,这是一种很巧妙的隐式 cross-attention。
标准 masked diffusion LM 会经过多步去噪:
DFlash 只经过 single forward pass:
它将 diffusion parallelism 变成一个权衡了高质量和低延迟的 speculative drafter。